로딩 중...
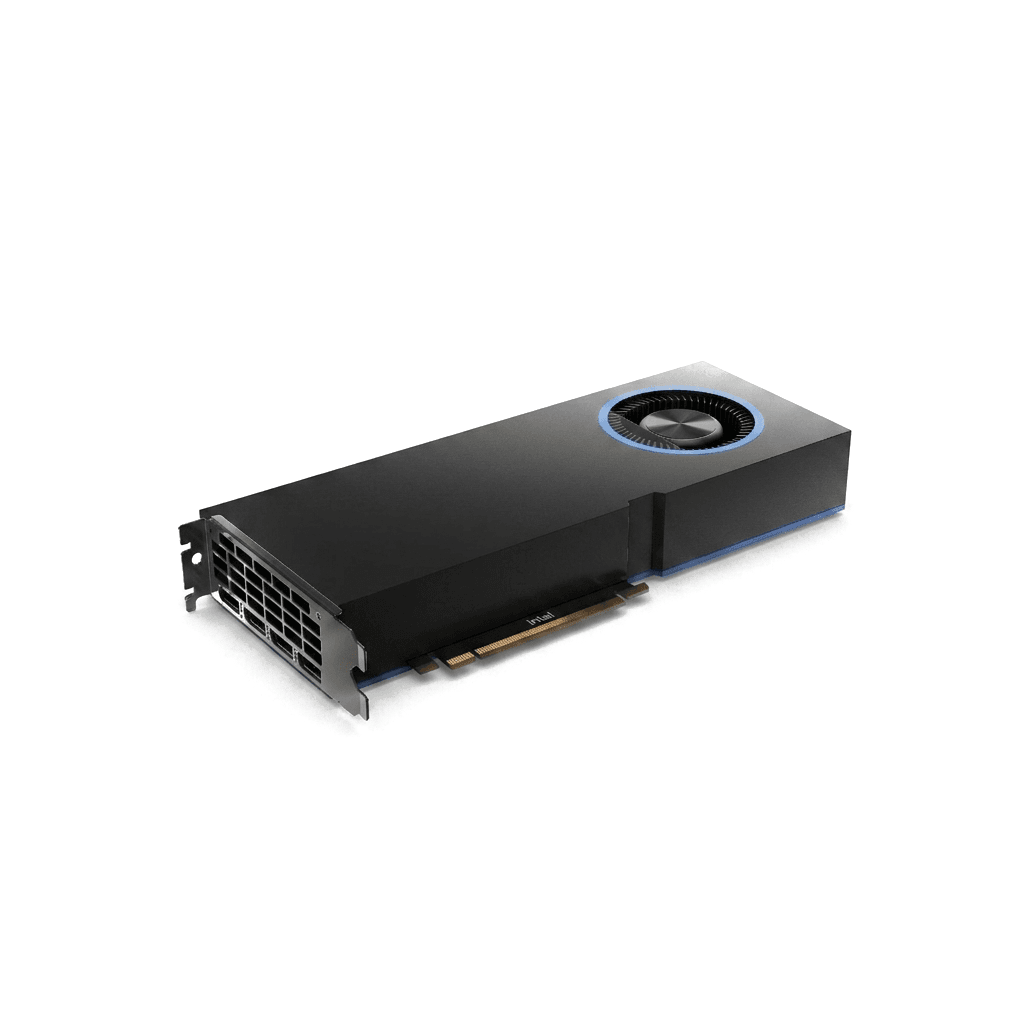
Arc Pro B70
32GB. 로컬 AI의 새로운 기준.
클라우드 없이, 32GB의 여유로
27B 모델을 내 데스크에서.
하나의 GPU,
세 가지 선택.
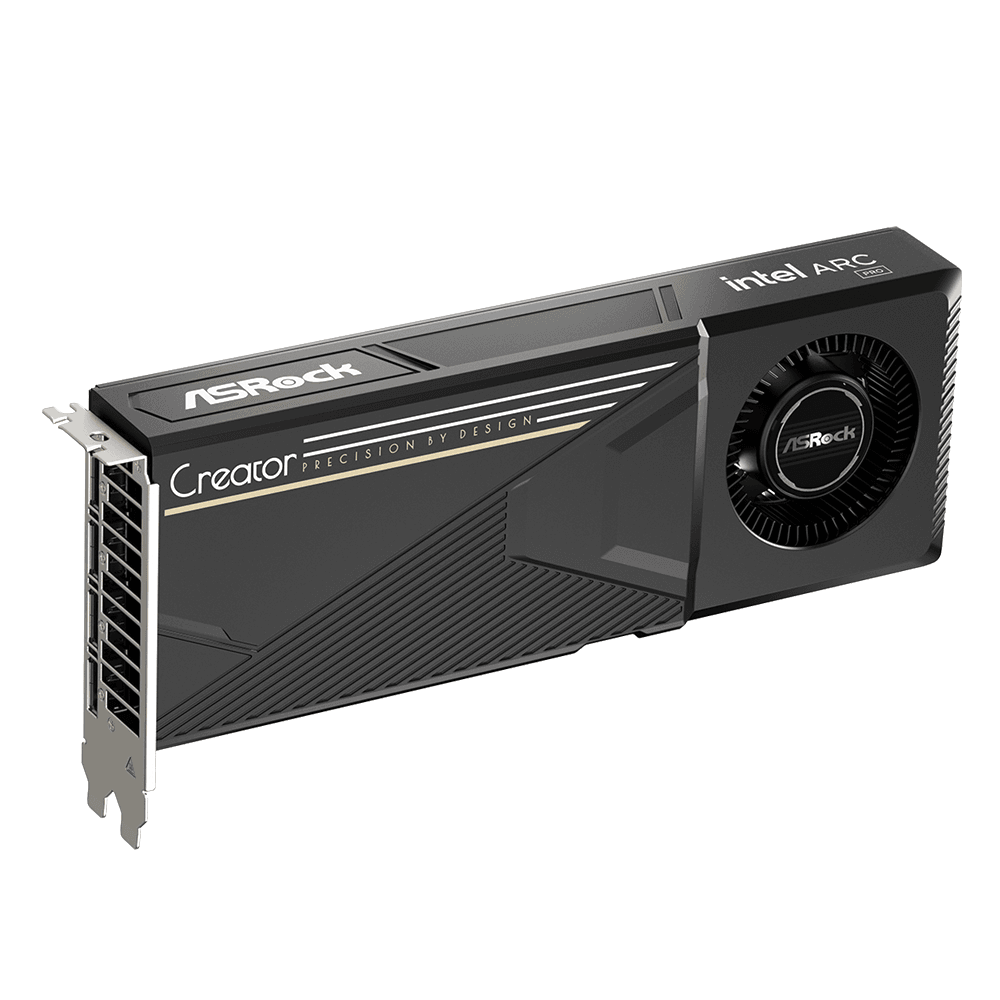
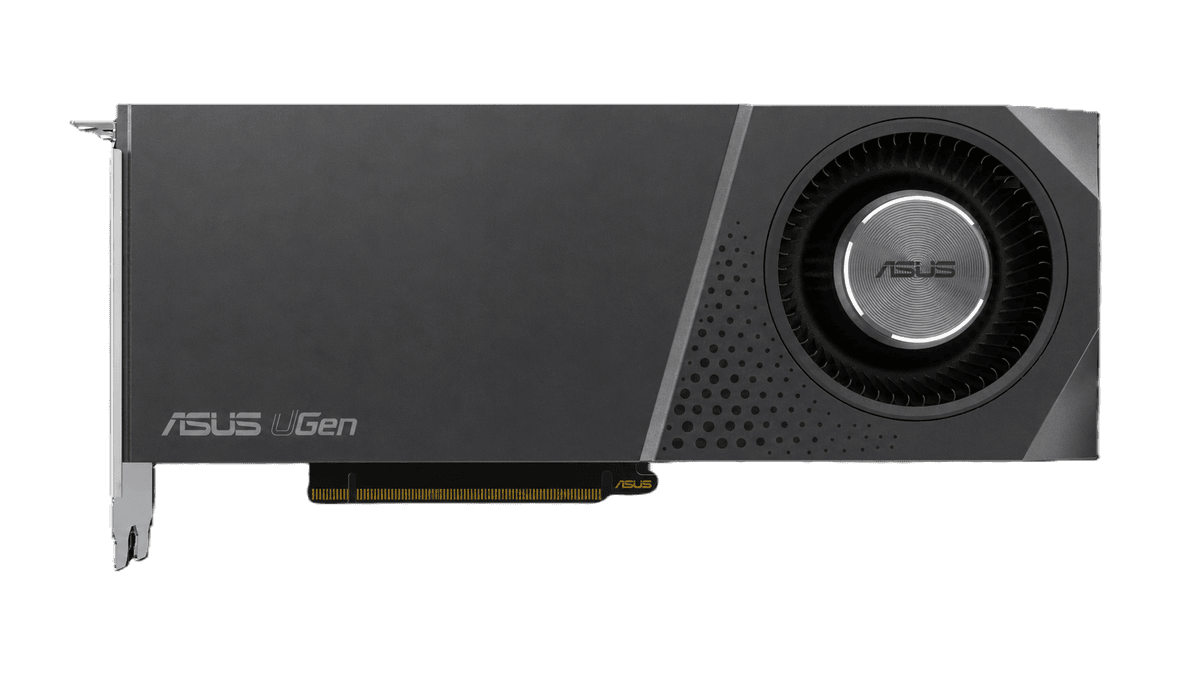
Intel 레퍼런스 · ASRock Creator · ASUS UGen
VRAM
32GB
GDDR6 ECC · 256-bit
AI 연산
367TOPS
INT8 · 256 XMX 엔진
대역폭
608GB/s
추론 최적화 메모리 서브시스템
소비 전력
290W
TBP · 2슬롯 풀하이트
Why 32GB
AI 모델은 메모리에 통째로 올라가야 돌아갑니다. 16GB 카드는 14B를 넘는 모델이나 고정밀 추론에서 한계에 닿고, 부족한 VRAM은 데이터를 시스템 메모리로 밀어내며 성능을 10배 이상 떨어뜨립니다. 32GB는 27B급 모델 대부분을 양자화 없이 담고, 긴 컨텍스트와 멀티 에이전트의 KV 캐시까지 여유를 남깁니다.
모델 크기별 필요 VRAM (INT8 기준)
8B 모델9.6GB
13B 모델15.6GB
27B 모델32.4GB
16GB 카드24GB 카드B70 32GB
가중치 기준 추정치(파라미터 × 정밀도 바이트). 실제 운용 시 컨텍스트 길이·KV 캐시·배치 크기에 따라 약 20% 이상의 추가 메모리가 필요합니다. 출처: ASUS UGen B70 Sales Kit.
Performance
제3자 검증으로 확인된 추론 성능.
4.75×
첫 토큰 응답 속도 (TTFT)
A사 워크스테이션 GPU 대비 · Puget Systems
93K
컨텍스트 윈도우
32GB VRAM 기준 · Intel 공식
369
tokens/s · 50 동시 요청
vLLM · Level1Techs
4.1×
달러당 최대 모델 파라미터
B사 플래그십 GPU 대비 · Newegg 2026/06
첫 토큰 지연 시간 (초, 낮을수록 좋음)
Intel Arc Pro B700.08s
B사 워크스테이션 GPU0.17s
A사 워크스테이션 GPU0.38s
토큰 생성 속도 (tok/s, 높을수록 좋음)
Intel Arc Pro B70123
A사 워크스테이션 GPU115
B사 워크스테이션 GPU115
출처: Puget Systems Intel Arc Pro B70 Review (2026/06), Intel 공식 벤치마크, Level1Techs, Newegg.com 2026/06/29. 테스트 환경·모델·양자화 설정에 따라 결과는 달라질 수 있습니다.
Local LLM
데이터는 PC 밖으로 나가지 않고, 토큰 비용은 청구되지 않습니다. Intel Arc Pro B70은 llama.cpp, vLLM, Ollama, OpenVINO 등 검증된 스택 위에서 Llama, Qwen, DeepSeek, gpt-oss 같은 오픈 모델을 그대로 구동합니다. 카드를 더하면 64GB, 128GB로 확장됩니다.
클라우드 의존 없이 데이터를 사내에 두고, 24GB 카드에 올라가지 않는 모델을 구동합니다. 듀얼 B70(64GB)은 llama.cpp SYCL에서 MoE 모델을 단일 카드 54.7 tok/s로, 80B급 모델을 43.4 tok/s로 처리합니다. 원클릭 스크립트로 4장 구성 540 tok/s 추론 서버를 세울 수 있습니다.
스택: llama.cpp SYCL · vLLM XPU · Ollama
Lineup
같은 B70, 세 브랜드의 마감.
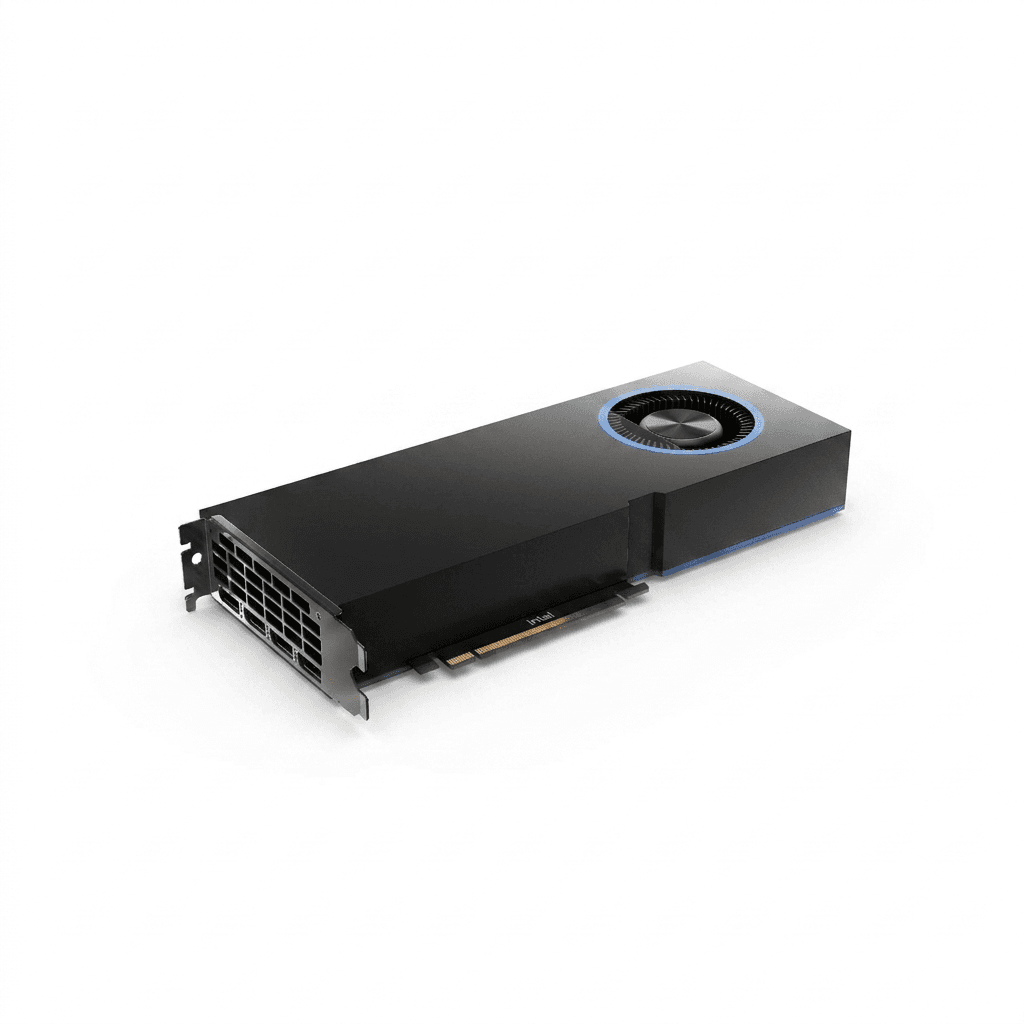
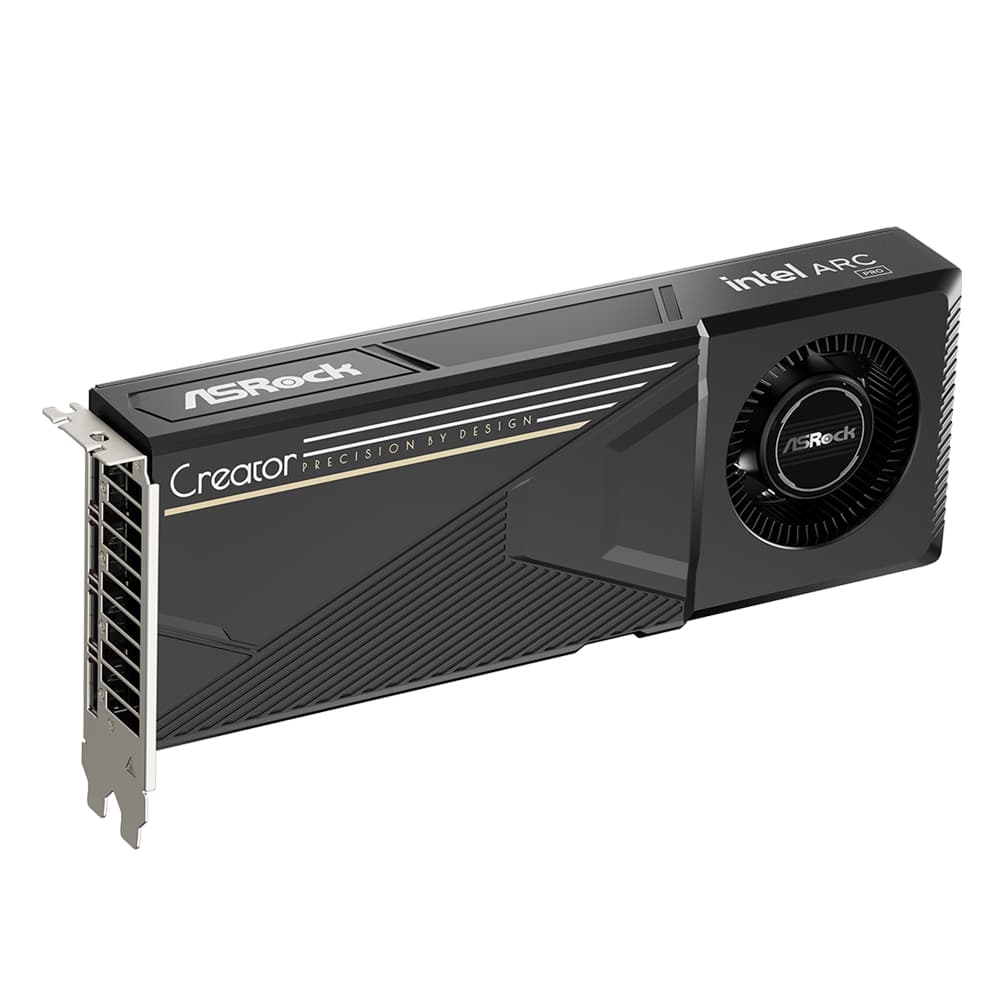
ASRock Arc Pro B70
Creator 32GB
Creator 32GB
Precision by Design. 크리에이터 워크스테이션을 위한 골드 라인 마감, 3년 품질보증.
가격 문의
이 모델로 견적 요청 →
ASUS UGen Arc Pro
B70 32G
B70 32G
ASUS UGen AI 가속기 라인업의 코어 시리즈. MuseBox · Multi-LM Tuner 소프트웨어 번들.
가격 문의
이 모델로 견적 요청 →세 모델 모두 동일한 Intel Arc Pro B70 GPU · 32GB GDDR6 ECC · 290W TBP 사양을 공유합니다. 쿨링 설계와 보증 정책은 브랜드별로 다릅니다.
Systems
한 장에서 네 장까지. 규모에 맞게.
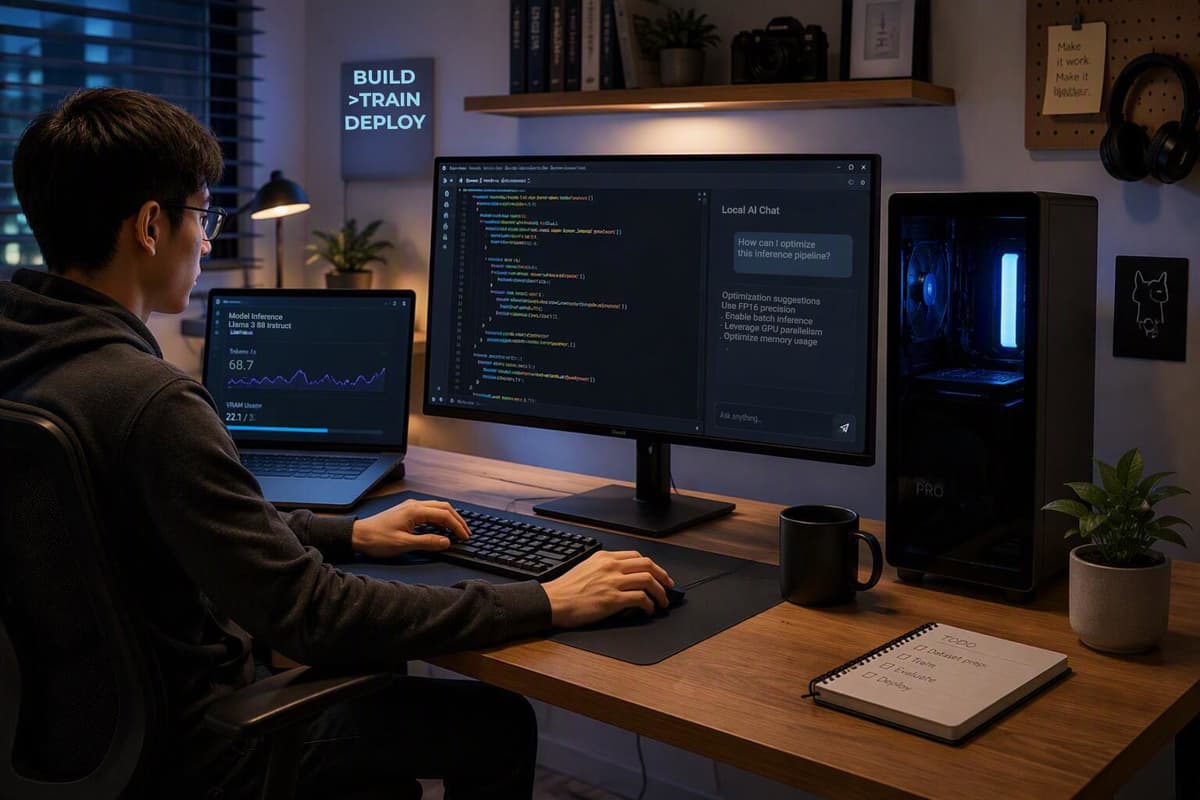
싱글 카드 · 32GB
Prosumer
개인 전문가 · AI 개발자
16GB 카드로는 14B를 넘는 모델이나 고정밀 추론에서 막힙니다. 32GB 한 장이면 27B 미만 모델 대부분을 그대로 올리고, 최적화 시 더 큰 모델도 구동합니다.
이 구성으로 견적 요청 →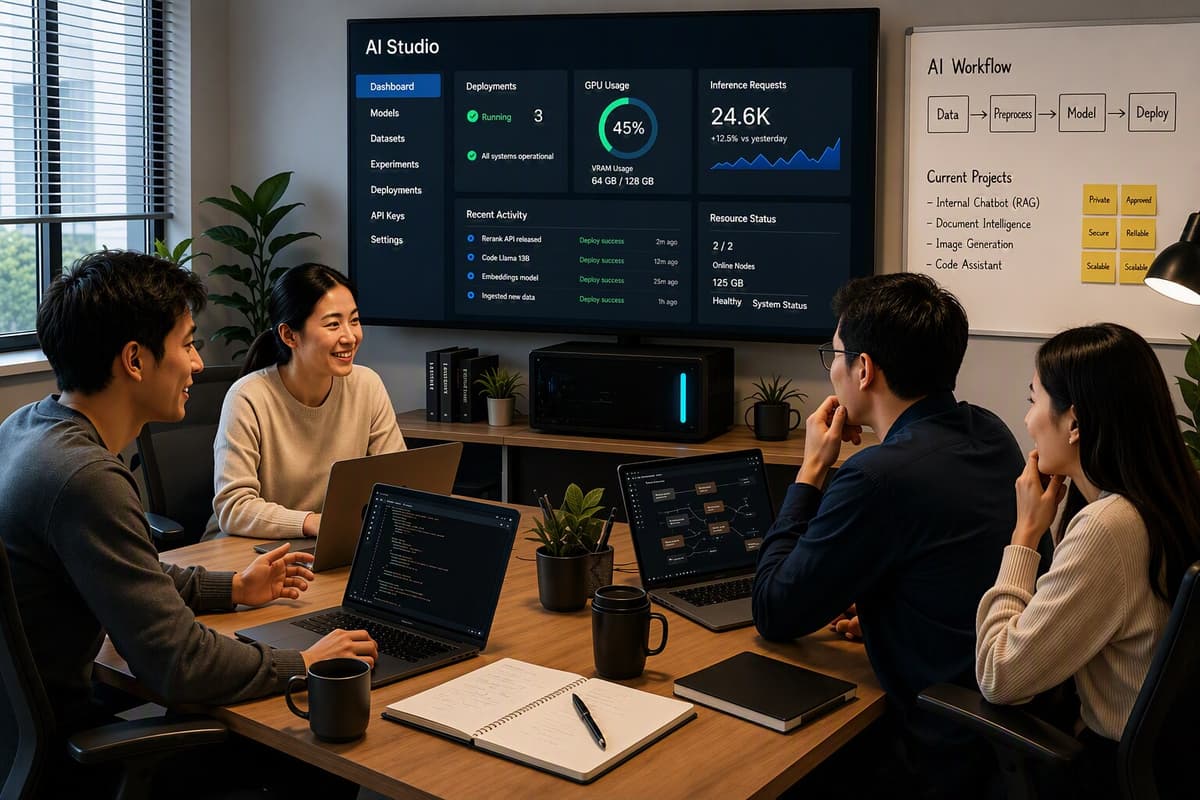
듀얼 카드 · 64GB
Studio
소규모 기업 · 크리에이티브 스튜디오
클라우드 추론은 쓸수록 비용이 오르고 민감한 데이터가 밖으로 나갑니다. 듀얼 카드 64GB는 80B급 모델을 43.4 tok/s로 구동하며, 모든 데이터를 사내에 둡니다.
이 구성으로 견적 요청 →
멀티 카드 · 128GB
Enterprise
기업 부서 단위 AI 팀
클라우드 API는 백만 토큰당 수십 달러, 컴플라이언스 부담은 별도입니다. 4장 128GB 구성은 원클릭 스크립트로 540 tok/s 추론 서버를 세우고, 장기 비용을 낮춥니다.
이 구성으로 견적 요청 →4.2개월
클라우드 API 대비 투자 회수 기간.
10명이 월 2,000만 토큰씩 쓰는 팀 기준. 4장 B70 시스템($18,400)으로 27B 모델을 돌리면 백만 토큰당 전기료 포함 $3.18. 프론티어 클라우드 모델의 출력 토큰 단가 $25와 비교하면 월 $4,364이 절감됩니다. 그 이후는 데이터 프라이버시와 오프라인 가용성이 덤으로 남습니다.
백만 토큰당 비용
로컬 B70 ×4 · 27B 모델$3.18
클라우드 프론티어 모델 (출력)$25.00
월 절감액
$4,364
초기 하드웨어
$18,400
출처: Puget Systems 2026/06, Anthropic 공시 가격 2026/07. 사용량·전기료·모델 선택에 따라 달라집니다.
Software
이미 쓰는 스택, 그대로.
Intel LLM Scaler 컨테이너 하나로 vLLM XPU 환경이 완성됩니다. INT4·FP8 온라인 양자화가 내장되어 외부 CUDA 양자화 툴이 필요 없고, PyTorch XPU는 2025년 GA 이후 정식 지원됩니다.
지원 프레임워크
Intel LLM Scaler / vLLM XPUllama.cpp SYCL · VulkanOllamaOpenVINO · oneAPIPyTorch XPUComfyUIBackend.AI
검증된 모델
Llama 3.1 / 3.2 (8B–70B)Qwen 3.x (7B–80B)DeepSeek-R1 DistillMistral · Mixtralgpt-oss (20B, 120B)Whisper-large-v3InternVL3.5
최대 검증 사례: Qwen3-Coder 80B @ 43.4 tok/s (듀얼 카드)
주요 사양
- GPU 아키텍처
- Intel Xe2 · TSMC 5nm (N5) · 32 Xe-코어 · 256 XMX AI 엔진
- AI 연산
- 최대 367 TOPS (INT8)
- 메모리
- 32GB GDDR6 ECC · 256-bit · 608 GB/s
- 부스트 클럭
- 2,800 MHz
- 인터페이스
- PCIe 5.0 x16 (네이티브)
- 디스플레이 출력
- DisplayPort 2.1 UHBR13.5 ×3 · HDMI 2.1b ×1 · 최대 7680×4320 @120Hz
- 소비 전력
- TBP 290W
- 폼팩터
- 풀하이트 · 2슬롯
- 멀티 GPU
- 최대 4장 · 128GB VRAM
- 소프트웨어
- Intel Extension for PyTorch · oneAPI · OpenVINO · Vulkan · vLLM XPU · llama.cpp SYCL
공통 GPU 사양 기준. 브랜드별 쿨링·클럭·보증 조건은 각 제품 상세를 확인해 주세요.